září 2026
Personal Knowledge Base
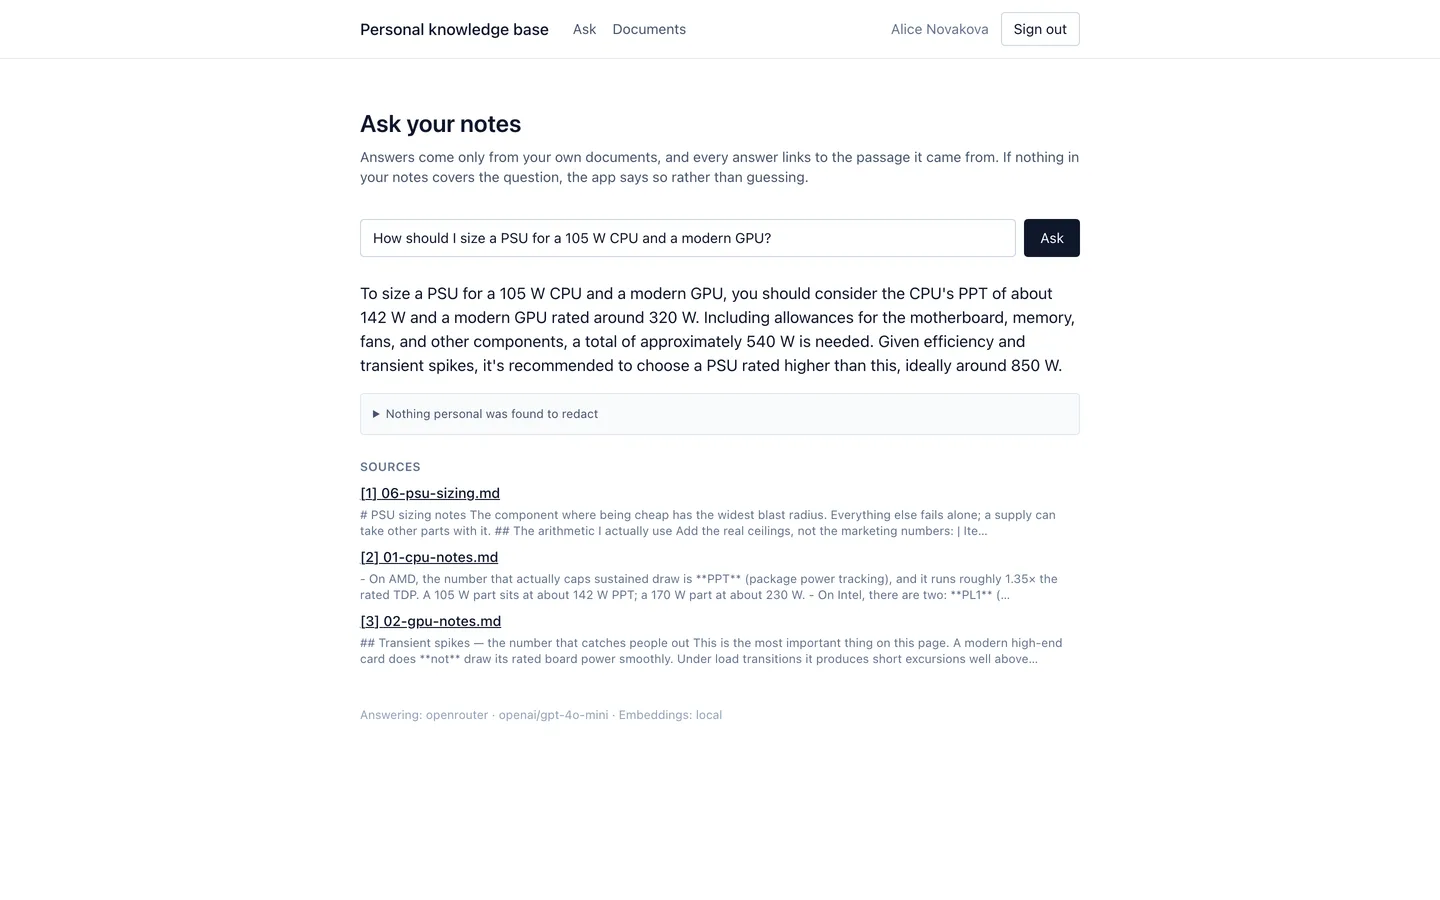
Znalostní báze, které se dá ptát. Každá odpověď ukazuje zpátky na dokument, ze kterého pochází, a když na otázku vaše vlastní poznámky neodpovídají, aplikace to řekne, místo aby si vymýšlela.
- Role
- Sólo projekt — retrieval, ochrana údajů, identita, infrastruktura
- Stack
- Next.js, TypeScript, Postgres, pgvector, Drizzle, Auth.js, Keycloak, Anthropic SDK, OpenRouter, transformers.js, Docker
Co to přináší
- Tři vyhledávací větve — vektorová, identifikátorová a BM25 nad prózou — spojené přes reciprocal rank fusion. Obě lexikální větve vznikly proto, že embedder měřitelně odmítl otázku, na kterou korpus odpověď má: „What are PL1 and PL2 set to?“ dostalo skóre 0,054 proti prahu 0,25, a to u dokumentu, který měla aplikace zaindexovaný.
- Citace odcházejí dřív než samotný text odpovědi. Model je v JSONu vrací jako první, pole se ověří v okamžiku, kdy se uzavře, a první slovo odpovědi jde ven až po kontrole zdroje — zamítnutá odpověď se tak odmítne ve chvíli, kdy na obrazovce pořád svítí kontrola zdrojů, místo aby se čtenáři brala zpátky, až si ji přečte.
- Jména, e-maily a telefonní čísla se ještě před odesláním nahradí zástupnými značkami a cestou zpátky se vrátí na místo. Embedder běží přímo v procesu, takže jediné, co vůbec překročí hranici sítě, je anonymizované volání modelu.
- Čtyři poskytovatelé odpovědí za jedním rozhraním — a není to jen tvrzení: stejný kód odpověděl přes OpenRouter na modelu od OpenAI a přes Anthropic SDK — jiná firma, jiný účet, jiný namespace modelů — beze změny promptu, kontroly citací, anonymizace i auditního záznamu.
Technický návrh
Jak se z otázky stane odpověď
app/api/ask/route.ts
O tom, čí dokumenty se prohledávají, rozhoduje session — tělo requestu uživatele pojmenovat nemůže. Tady se kontrolují i oba stropy útraty, uživatelský i společný pro celé nasazení, ještě než cokoli začne stát peníze.
server/rag/retrieve.ts
Otázka se zaembedduje přímo v procesu a pak běží tři hledání: vektorová podobnost, přesná shoda identifikátoru, pokud otázka obsahuje něco ve tvaru čísla dílu, a BM25 nad prózou. Každá větev si filtr na vlastníka a na model embeddingu opakuje ve vlastním SQL, místo aby spoléhala na tu vedlejší.
server/rag/fuse.ts
Fúze jenom řadí — každý seznam přichází už odfiltrovaný, takže prázdný výsledek zůstane prázdný. Když se nenajde nic, request končí právě tady, hláškou „Not found in your knowledge base.“ a bez jediného volání modelu.
server/privacy/anonymizer.ts
Jedna instance anonymizéru na request nahradí osoby, e-maily a telefonní čísla v otázce i v každém nalezeném úryvku. Obojí dělá ta samá instance, takže otázka na konkrétního člověka pořád sedne na poznámku o něm.
server/ai/prompts.ts
Otázka i zdroje cestují uvnitř značek, které píše aplikace, a první pravidlo systémového promptu říká, že všechno uvnitř nich jsou data. Text, který vypadá jako jedna z těch značek, se escapuje, ne odstraní — věta, která to zkusila, je pořád obsahem poznámky.
server/ai/call.ts
Jediné místo, kde text opouští proces. Vynucuje timeout a zapisuje auditní řádek — model, časy, počty tokenů, výsledek — a nikdy ne obsah.
server/rag/citations.ts
Každé citované číslo musí ukazovat do sady, která se skutečně odeslala. Citace je pozice, ne id, takže model žádné existující vymyslet nemůže. Když neprojde ani jedna, následuje jeden přísnější pokus a pak se odpověď odmítne.
server/privacy/restoreStream.ts
Ze zástupných značek se cestou ke čtenáři zase stanou skutečná jména. Mapování, které to umí, žije v rámci requestu a spolu s ním zaniká — nikdy se neukládá ani neloguje.
Klient
app/ask/ask-form.tsx
Server
server/auth/guard.ts
server/rag
server/privacy
server/ai/providers
Čtyři implementace: anthropic, openrouter, gateway, mock.
server/ai/embedders/local.ts
Přímo v procesu. Žádný text se kvůli embeddingu nikam neposílá.
Data
Postgres
pgvector, HNSW cosine
384 dimenzí, kosinová vzdálenost.
content_tsv / content_tsv_en
Generované sloupce: simple pro identifikátory, english pro prózu.
Drizzle ORM
Externí služby
Keycloak (OIDC)
Realm je součástí compose souboru.
Anthropic API
OpenRouter
POST /api/ask
Drizzle
- Citace dřív než text, přímo ve formátu přenosu. V NDJSON streamu nikdy nepřijde delta před citations, takže ani klient, který by ignoroval všechna ostatní pravidla, nedokáže vykreslit text bez zdroje. Zisk na latenci je malý — čas do prvního tokenu je 84–94 % celého volání — a přesně o to jde: streamovat nejdřív text by vypadalo mnohem líp a ukazovalo by věty, které žádná kontrola neschválila.
- Dva seamy, ne jeden. Anthropic embeddings endpoint nemá, takže jedno společné rozhraní pro poskytovatele by soubor pojmenovaný po nich nemohl implementovat. Odpovídání a embedding jsou oddělená rozhraní a embedder ve výchozím nastavení běží uvnitř kontejneru — díky tomu se indexovaný text do sítě vůbec nedostane.
- Tři vyhledávací větve místo nižšího prahu skóre. Práh, který se snižuje tak dlouho, dokud chyby nezmizí, je práh nastavený od oka — a odmítnutí je to jediné, co na tom stát nesmí. Identifikátorová větev hledá každý výraz jako frázi a prózová se pouští podle pokrytí IDF a dvou shodných výrazů, takže větev buď má důkaz, nebo neběží.